Hack Sudoku.com: Khi F12 bất lực trước Canvas và câu chuyện tự chế OCR siêu nhẹ
Có một câu nói vui trong giới lập trình: "Mọi trò chơi giải đố sinh ra trên đời thực chất chỉ là một bài toán cấu trúc dữ liệu và giải thuật đang đợi người viết code giải hộ."
Nhớ lại hồi tháng 9 năm 2023, mình từng có một bài viết chia sẻ về việc làm tool giải game mang tên Sudoku Solver. Khi ấy, "nạn nhân" là tựa game Sudoku 999 tải từ Microsoft Store về máy Windows. Cách tiếp cận lúc đó mang đậm phong cách cổ điển của dân vọc vạch hệ thống: bật Cheat Engine lên scan địa chỉ ô nhớ đầu tiên trong RAM, tính offset sang ô tiếp theo, rồi viết vài dòng C# dùng ReadProcessMemory kéo thẳng mảng 9x9 về máy tính. Kéo được dữ liệu về rồi thì nhét vào thuật toán Backtracking, bùm một phát chưa đầy vài mili-giây là toàn bộ bàn cờ đã được giải sạch sẽ. Trên Windows, một khi đã cầm được quyền đọc RAM của tiến trình thì cảm giác chẳng khác gì cầm "chìa khóa vạn năng", thích đọc lúc nào thì đọc, thích sửa số nào thì sửa.
Bẵng đi một thời gian, dạo gần đây rảnh rỗi lướt web, mình tình cờ ghé vào trang sudoku.com — một trong những trang web chơi Sudoku trực tuyến phổ biến nhất hiện nay. Thế là cái tính tò mò muôn thuở lại trỗi dậy: "Liệu trên môi trường Web, mình có thể làm một con bot tự động soi bài và giải tương tự như hồi làm trên Windows hay không?"
Nhưng ngay khi vừa bắt tay vào việc, một gáo nước lạnh đã dội thẳng vào mặt mình.
🛑 Bất ngờ đầu tiên: Bấm F12 lên và... chẳng có cái DOM nào cả!
Với một lập trình viên web bình thường, mỗi khi muốn can thiệp hay tự động hóa thứ gì đó trên trình duyệt, phản xạ tự nhiên đầu tiên luôn là nhấn tổ hợp phím bất hủ: F12 hoặc chuột phải chọn Inspect Element.
Thường thì những web game dạng lưới như Caro, Cờ vua hay Dò Mìn (giống như đợt mình làm Extension giải Minesweeper.online) đều dựng bàn cờ bằng HTML DOM truyền thống. Mỗi ô vuông sẽ là một thẻ <div> hoặc <td>, bên trong chứa sẵn tọa độ data-x, data-y, kèm theo chữ số hiển thị rõ ràng trong thẻ. Nếu Sudoku.com cũng làm như thế thì nhàn quá: chỉ cần mở Console, gõ nhẹ một dòng document.querySelectorAll('.cell') rồi map qua lấy innerText là đã có ngay ma trận 9x9 trong vòng đúng một nốt nhạc.
Nhưng không. Đời không như là mơ!
Khi mình trỏ chuột vào giữa bàn cờ Sudoku.com để soi thẻ thì đập vào mắt là một thẻ HTML trơ trọi duy nhất:
<canvas width="600" height="600"></canvas>
Đúng vậy, toàn bộ bàn cờ 9x9 — từ các đường kẻ chia ô, các khối 3x3, màu nền khi chọn ô, cho đến từng con số từ 1 đến 9 — tất cả đều được render trực tiếp lên một chiếc thẻ <canvas> 2D!
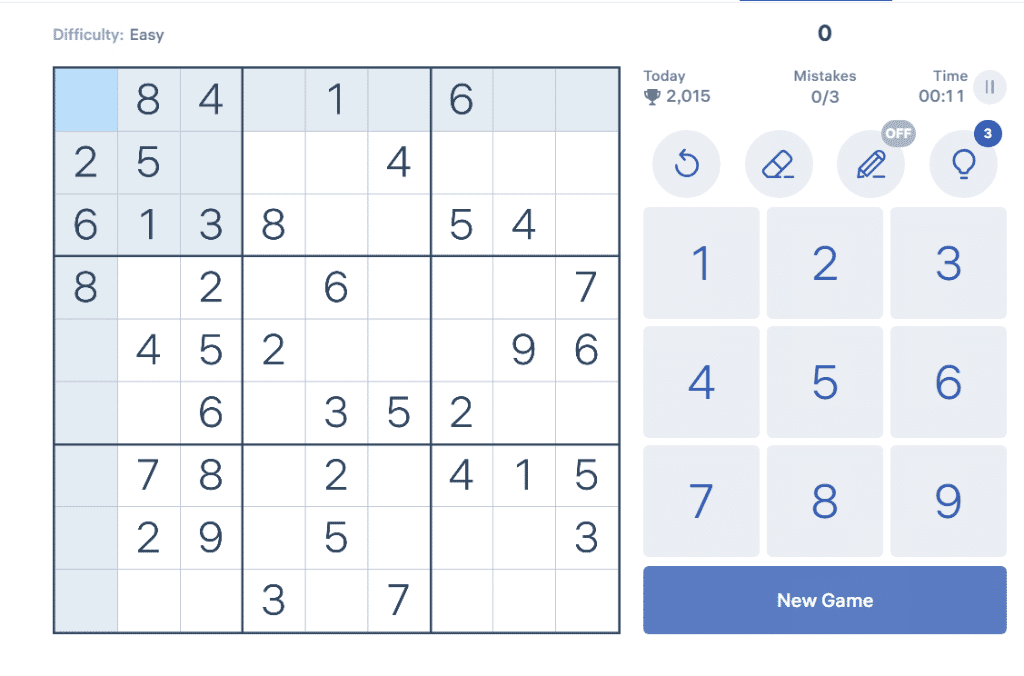
Bên trong cây DOM hoàn toàn không hề có khái niệm "ô số 1 hàng 2 cột 3". Không có chữ số nào để bóc tách, không có text node, không có class trạng thái. Đối với trình duyệt, bàn cờ lúc này chỉ là một tấm ảnh phẳng chứa hàng triệu pixel màu sắc liên tục được vẽ lại.
Tất nhiên, nếu cố đào sâu vào mớ JavaScript đã bị minify, bundle và làm rối (obfuscated) của trang web, ta vẫn có thể tìm cách hook vào các biến state ngầm hay instance của engine game. Nhưng cách này cực kỳ mệt mỏi và rủi ro: chỉ cần bên phát triển game cập nhật một bản build mới, đổi tên biến hay đổi cấu trúc store là tool sẽ "ngủm củ tỏi" ngay lập tức.
Đứng trước bức tường Canvas, một câu hỏi nảy ra trong đầu: Con người chúng ta nhìn vào bàn cờ Sudoku thế nào để giải?
Mắt chúng ta nhìn vào màn hình, thu nhận ánh sáng, nhận diện hình dáng nét vẽ để biết ô nào đang chứa số mấy, rồi gửi tín hiệu lên não để suy luận. Vậy thì tại sao ta không dạy cho con bot một "đôi mắt" tương tự?
Nếu web đã vẽ lên Canvas, thì hướng tiếp cận chuẩn chỉ và lì lợm nhất chính là: Chụp ảnh Canvas và ứng dụng Computer Vision / OCR để tự đọc con số!
💡 Ngã rẽ công nghệ: Vác "đại bác" Tesseract hay tự chế OCR?
Nghĩ đến việc nhận diện chữ viết trong ảnh (OCR), 9 trên 10 lập trình viên sẽ nghĩ ngay đến tesseract.js — một thư viện OCR mã nguồn mở cực kỳ nổi tiếng.
Lúc đầu mình cũng nhen nhóm ý định lôi Tesseract vào cho tiện. Nhưng chỉ sau vài phút cân nhắc, mình nhận ra giải pháp này có quá nhiều điểm bất cập:
- Quá nặng nề: Thư viện tesseract kèm theo bộ core WebAssembly và dữ liệu model trained sẵn nặng tới hàng chục Megabyte. Nhét một con voi vào một cái extension nhỏ gọn là điều không thể chấp nhận được.
- Độ trễ cao: Khởi tạo Worker, load dữ liệu ngôn ngữ rồi chạy mạng nơ-ron nhận diện một tấm ảnh thường mất từ 1 đến 2 giây. Trong khi mục tiêu của mình là tool phải phản hồi tức thì, mượt mà trong chớp mắt.
- Bài toán thực tế quá đặc thù: Tesseract được thiết kế để giải quyết bài toán OCR tổng quát (chữ in, chữ viết tay, nghiêng ngả, méo mó). Nhưng nhìn lại bài toán của mình xem: Ta chỉ cần đọc đúng 9 chữ số (từ 1 đến 9), được in bằng duy nhất một bộ font cố định, trên một lưới 9x9 thẳng thớm, nền trắng chữ đậm cực kỳ rõ ràng!
Chẳng lẽ để bắt vài con chim sẻ mà lại phải vác cả khẩu đại bác Deep Learning ra bắn?
Không cần thiết. Mình quyết định tự tay xây dựng một bộ nhận diện hình ảnh và OCR siêu nhẹ (Zero-dependency) chạy trực tiếp bằng TypeScript thuần ngay trên trình duyệt.
🛠️ Quá trình "khai mắt" cho con bot: Từ mảng pixel thô đến con số biết nói
Không đi vào chi tiết vụn vặt của từng dòng code, nhưng câu chuyện xử lý hình ảnh phía sau thực sự là một chuỗi những lần "Aha!" cực kỳ thú vị.
+-----------------------------------------------------------+
| 1. Lấy Canvas Context 2D -> getImageData() (Pixel Buffer) |
+-----------------------------------------------------------+
                             ↓
+-----------------------------------------------------------+
| 2. Chia lưới 9x9 -> Cắt xén bỏ đường biên (Padding)       |
+-----------------------------------------------------------+
                             ↓
+-----------------------------------------------------------+
| 3. Nhị phân hóa (Luminance Threshold) -> Tách mực đen     |
+-----------------------------------------------------------+
                             ↓
+-----------------------------------------------------------+
| 4. Loang điểm ảnh (BFS Flood Fill) -> Bounding Box chữ số |
+-----------------------------------------------------------+
                             ↓
+-----------------------------------------------------------+
| 5. Scale về ma trận 20x20 -> So khớp mẫu (Bit Matching)   |
+-----------------------------------------------------------+
                             ↓
+-----------------------------------------------------------+
| 6. Backtracking Solver -> Vẽ Overlay đáp án lên Canvas    |
+-----------------------------------------------------------+
Bước 1: Trích xuất pixel và cuộc chiến với đường kẻ lưới
Nhờ Canvas của Sudoku.com được vẽ cùng origin, ta có thể dễ dàng gọi hàm getImageData của Canvas 2D Context để lấy về mảng pixel thô dạng Uint8ClampedArray (gồm 4 kênh R, G, B, A cho từng điểm ảnh).
Kế tiếp là chia kích thước Canvas thành 9 hàng và 9 cột. Tuy nhiên, nếu cứ bổ thẳng theo kích thước width / 9 và height / 9 thì sẽ gặp rắc rối to: các đường kẻ lưới màu xám đen ngăn cách giữa các ô sẽ lọt thẳng vào rìa của từng ô con. Khi quét pixel, con bot sẽ nhìn nhầm các đường kẻ dọc thẳng đứng đó thành... nét của số 1!
Để giải quyết, mình áp dụng kỹ thuật padding: mỗi ô con khi cắt ra sẽ được thụt lùi vào trong khoảng 8% kích thước viền. Bằng cách này, toàn bộ đường kẻ lưới xung quanh bị loại bỏ sạch sẽ, chỉ giữ lại phần ruột bên trong ô.
Bước 2: Nhị phân hóa và thuật toán loang điểm ảnh (BFS)
Dữ liệu ảnh sau khi cắt viền vẫn là ảnh màu RGB. Để nhận diện dễ dàng, ta cần biến nó thành ảnh đen trắng (nhị phân):
- Điểm nào có độ sáng (luminance) thấp hơn ngưỡng quy định thì đánh dấu là
1(có mực vẽ). - Điểm nào sáng hơn thì đánh dấu là
0(nền trống).
Nhưng trong thực tế chơi game, người dùng có thể đang di chuột qua ô (hover), hoặc ô đó đang được tô màu highlight xanh nhạt. Nếu chỉ đếm số lượng pixel đen đơn thuần thì rất dễ bị nhiễu.
Giải pháp ở đây là sử dụng thuật toán Connected Component Analysis thông qua hàng đợi BFS (loang điểm ảnh):
- Duyệt qua từng pixel đen trong ô, tìm kiếm tất cả các pixel đen lân cận dính liền với nó để gom thành từng "cụm" (blob).
- Nếu một cụm chỉ có vài pixel li ti -> coi là hạt bụi rác, loại bỏ thẳng tay.
- Cụm nào có kích thước lớn nhất và chiều cao đạt chuẩn của một chữ số -> đích thị là con số cần tìm!
- Bọc cụm điểm ảnh đó vào một chiếc hộp hình chữ nhật ôm khít (Bounding Box) từ tọa độ cực tiểu đến cực đại
(minX, minY, maxX, maxY).
Bước 3: Chuẩn hóa 20x20 và phép thuật Template Matching
Đây chính là trái tim của toàn bộ hệ thống OCR.
Một khi đã bóc tách được Bounding Box của chữ số, dù chữ số đó nằm ở ô nhỏ hay ô to (do độ phân giải màn hình hoặc responsive của trình duyệt thay đổi), mình đều dùng thuật toán nội suy để nén/giãn chiếc hộp đó về một ma trận cố định kích thước 20x20 điểm (tổng cộng 400 bit nhị phân).
Mỗi chữ số được đưa về dạng một "chữ ký số" gồm đúng 400 bit.
Trước đó, mình đã trích xuất sẵn mẫu chuẩn của 9 chữ số từ 1 đến 9 của chính font chữ Sudoku.com, rồi nén 400 bit của mỗi số thành một chuỗi Hex dài 100 ký tự để lưu sẵn trong code.
Khi cần nhận diện một ô:
- Nén chữ số trong ô thành mảng 400 bit.
- Đem 400 bit này đi so sánh song song với 9 mẫu chuẩn (1 đến 9).
- Đếm số lượng bit trùng khớp (tính theo khoảng cách Hamming).
- Mẫu số nào có điểm số tương đồng cao nhất (thường đạt trên 70-80% số bit trùng) -> kết luận luôn ô đó chứa số đó!
Tốc độ xử lý của phương pháp này nhanh đến mức đáng kinh ngạc: Toàn bộ 81 ô cờ được quét, lọc nhiễu, chuẩn hóa và nhận diện chính xác 100% chỉ trong vòng chưa đầy 5 mili-giây! Không tốn CPU, không cần tải model nặng nề, và quan trọng nhất là không phụ thuộc vào bất kỳ thư viện ngoài nào.
🎨 Trình diễn đáp án: Tấm gương vô hình (Overlay)
Đã có dữ liệu bàn cờ trong tay, việc giải Sudoku thì đã quá quen thuộc: thuật toán Backtracking (kết hợp suy luận loại trừ ràng buộc hàng, cột, khối) giải bài toán trong chưa đầy 1 mili-giây.
Nhưng câu hỏi cuối cùng là: Làm sao để hiển thị đáp án cho người dùng?
Tự động mô phỏng click chuột và bàn phím để điền hộ ư? Cách đó biến con bot thành một cỗ máy tự chơi vô hồn, vừa dễ làm game giật cục nếu gửi sự kiện chuột dồn dập, vừa làm mất đi niềm vui của người chơi.
Thay vào đó, mình chọn cách tinh tế hơn: Dựng một lớp phủ HTML trong suốt (Transparent Overlay) nằm đè khít từng pixel lên trên chiếc Canvas.
Lớp Overlay này tự động đo đạc vị trí getBoundingClientRect() của thẻ Canvas, bám chặt theo kích thước và vị trí của game kể cả khi người dùng co giãn cửa sổ trình duyệt hay cuộn trang.
Trên lớp phủ này, mình cung cấp hai trải nghiệm thú vị:
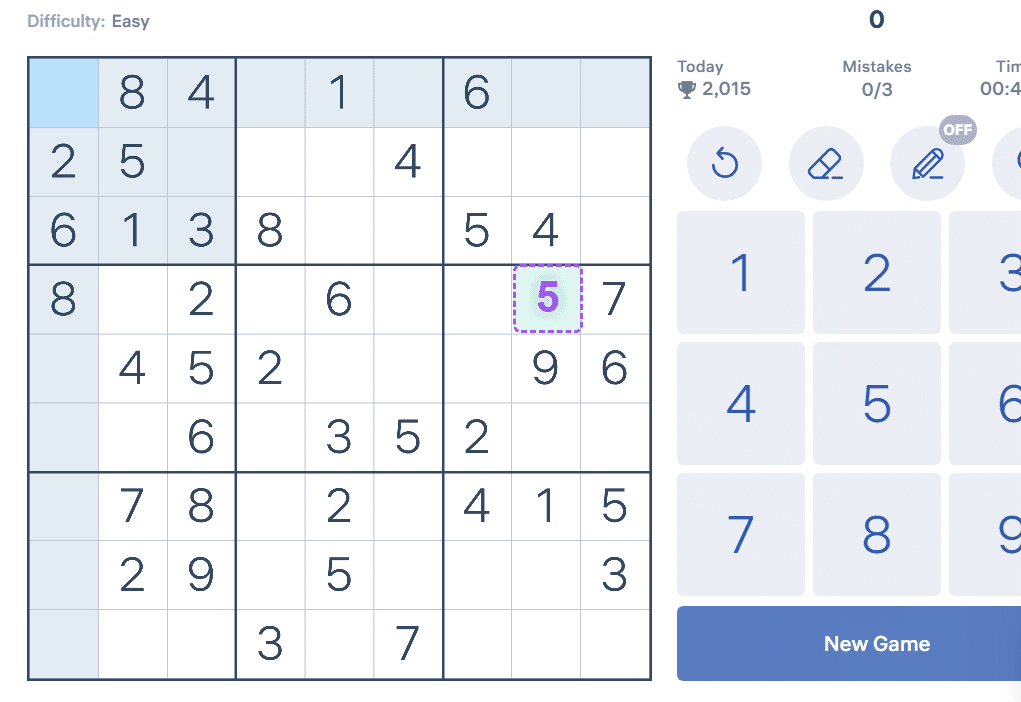
- Chế độ người thật (Human Helper): Thay vì spoil hết toàn bộ bàn cờ, bot sẽ tìm ô cờ có xác suất duy nhất chắc chắn nhất theo logic con người, rồi chiếu một ánh sáng viền nét đứt tím kèm số gợi ý lên đúng ô đó (như ô số 5 ở hình dưới). Ngay khi người chơi dùng bàn phím gõ con số đó vào, gợi ý sẽ tự động biến mất và bot lại âm thầm tính toán nước cờ tối ưu tiếp theo. Cảm giác như có một vị sư phụ đang ngồi sau lưng chỉ điểm!
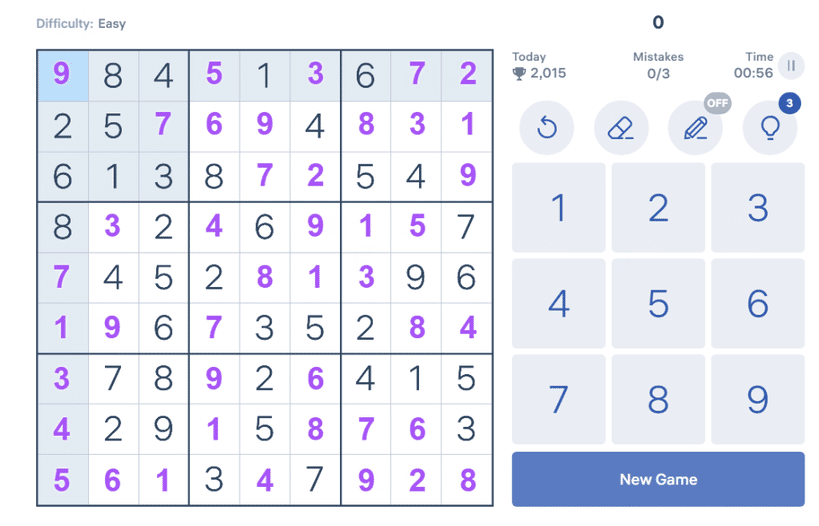
- Chế độ hiển thị toàn diện (Full Reveal): Dành cho những lúc muốn "bá đạo", toàn bộ 81 con số lời giải sẽ hiện lên nổi bật bằng gam màu tím cyber phủ lung linh trên nền bàn cờ mà không làm ảnh hưởng đến các số gốc của đề bài.
💭 Lời kết
Nhìn lại hành trình từ năm 2023 đến nay, mình thấy có một sự tương phản rất thú vị:
- Năm 2023: Môi trường Windows native, đối đầu với file
.dll64-bit, vũ khí là Cheat Engine, đọc từng byte ô nhớ RAM bằng con trỏ bộ nhớ C#. - Hiện tại: Môi trường Web browser, đối đầu với thẻ HTML5
<canvas>không một chút DOM, vũ khí là Computer Vision, thuật toán loang BFS và so khớp bit nhị phân để bóc tách thế cờ bằng chính "đôi mắt" của máy tính.
Cùng một trò chơi Sudoku, nhưng ở hai nền tảng khác nhau lại đòi hỏi hai hướng tư duy kỹ thuật hoàn toàn trái ngược. Và điều làm mình thích thú nhất sau mỗi dự án nho nhỏ thế này không phải là việc thắng thua một ván game, mà là cảm giác tự mình vượt qua những rào cản kỹ thuật: từ việc ngơ ngác khi thấy Canvas không có DOM, cho đến khi chứng kiến từng dòng thuật toán thị giác tự chế hoạt động trơn tru trong vài mili-giây.
Đôi khi, giải pháp tối ưu nhất cho một bài toán không nhất thiết phải là những mô hình AI khổng lồ hay thư viện hàng chục Megabyte, mà chỉ đơn giản là một chút tư duy về toán học, xử lý ảnh cơ bản và sự kiên trì bóc tách vấn đề mà thôi! 🚀